Nejnovější komentáře

Scalpeři krvácí: iPhone Duo nedokáží prodat draze a prodělávají
Milan Šurkala
dnes 13:04
Jste si jistý, že v Číně mají stejné zákony jako u nás?

GTA 6 první den utržilo 3,79 mld. USD. Překonalo všechny hry, filmy i alba historie
Jan Belka
dnes 12:50
si myslis ze 9070XT to neutahne na 60fps kdyz konzole je mnohonasobne…
Drahé DDR5 ovlivňují prodeje CPU u Amazonu: AM5 klesá, Arrow Lake padá
Jan Belka
dnes 12:49
ten propad u Intelu je brutalni teda.. jako 15 000 kusu AMD vuci 950…

Scalpeři krvácí: iPhone Duo nedokáží prodat draze a prodělávají
Jan Malý
dnes 12:30
Co to je za blbost? Však jako každý jiný člověk mohou do 14 dnů…

MSI EdgeMesa N AI+ přináší Nvidia RTX Spark v kompaktním těle
krtek kazatel
dnes 12:25
ani hovno :D koukam ty moz zkusenosti s provozovanim vlastnich modelu…
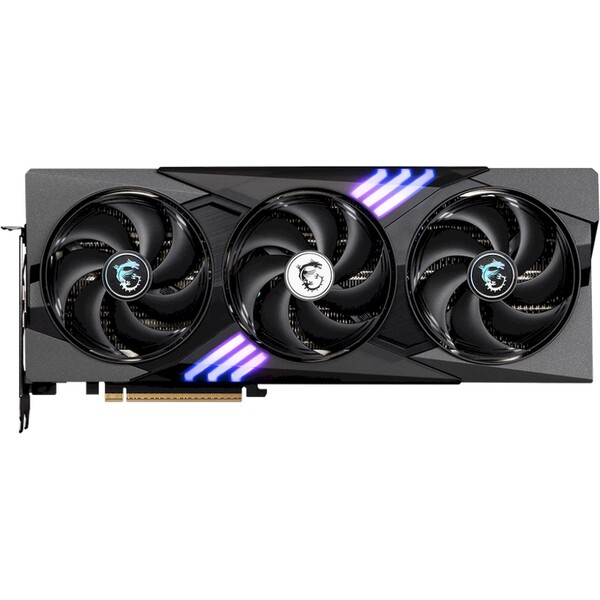
MSI NVIDIA GeForce RTX 5070 Ti GAMING TRIO OC 16GB GDDR7
38 990 Kč
Více informací
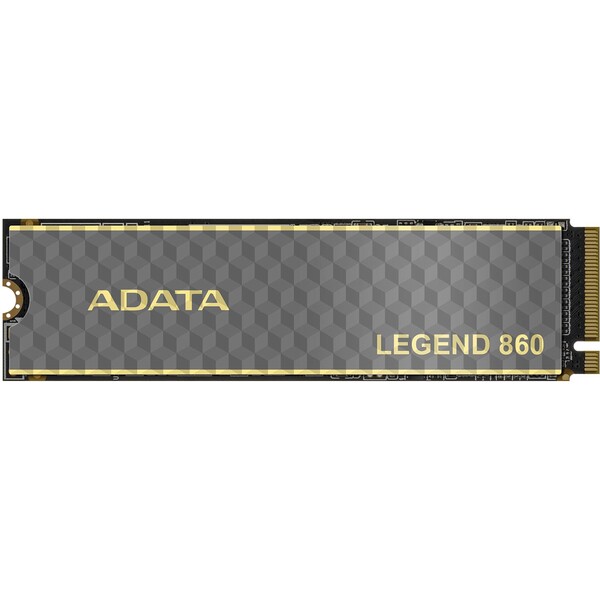
ADATA LEGEND 860 M.2 PCIe 4.0 1TB
3 990 Kč
Více informací
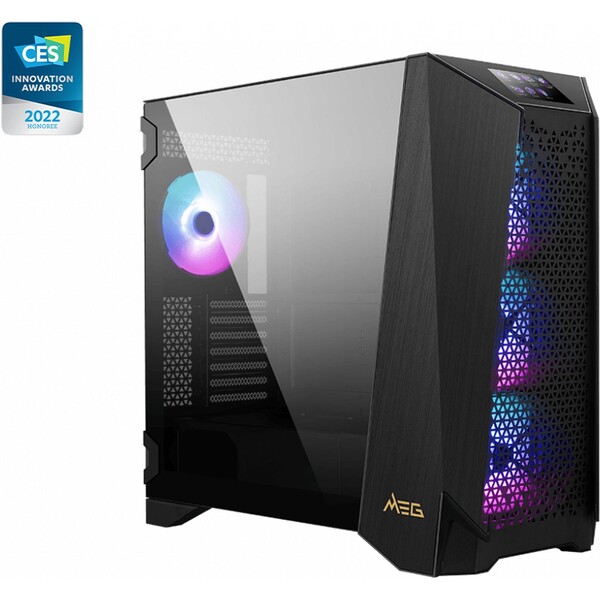
MSI MEG PROSPECT 700R
8 070 Kč
Více informací